Strara Engine - быстрый локальный AI на вёдрах и тазах
- Слышь, мужик, у тебя нейронка есть?
- Нету.
- Мужик! Я тебе нейронку принёс!
Как узко известно в широких кругах, в этом году у нас начался нейронопад, все кому не лень делают свои нейронки и вываливают их в народ и они всё лучше и лучше.
Совсем лучше наступило примерно в конце августа, счастья привалило наконец и локальным нейронщикам. Alibaba решил дропнуть новую локальную модель иии порвал зал.
Всё, почти все старые модели можно удалять, барахло! Данная моделька у нас Dence или Плотная, т.е. целиком должна загрузиться в память нашей видеокарты или видеокарт или того что мы используем для этого. Параметров у ней 27 биллионов, т.е. ну так, для локальной нейронки пойдет, всё дело в качестве! И вот тут АлиБаба не подвел, данная модель оказалась на редкость умной по сравнению с своими локальными предшественниками. Ну если не вдаваться маслом в деревья то чё-то типа Опусов годичной давности по тестам. Что большой прогресс! Учитывая нахаляву.
Но Алибабе показалось этого мало и они дропнули ещё одну модель. это у нас уже модель MoE, на 125 миллиардов параметров, из которых активны 6 миллиардов, плюс 51 миллиард параметров в блоке N-gram, это такой спец блок чтобы быстрее работало.
Вообще подробности можно прямо у самой неронки и спросить, нам из остального достаточно знать, что модель на 262 144 токенов контекста, расширяемых до одного мульта через YaRN.
Казалось бы, это что-то на серверном и ещё весной всё было бы именно так и ползало бы подобное на обычных ящиках в свои 2-3 токена если бы хватило оперативной памяти вообще запустить, особо с одним мультом контекста. Оно и сейчас то дофига, а раньше так и вообще!
Но! Тут появилась эта вот тема. Ну вот эта в которой я это всё пишу, а ещё появилась Strata.
Strata Qwen3.8-Flash-Next on any consumer hardware: one-click install for Windows / Linux. Strata inference engine, OpenAI/Anthropic API on localhost, optional image input.
Если коротенько, да, раньше была проблемка даже с MoE моделями, они все на обычной Лламе-цпп шли медленно, чтобы было много токенов надо было или сервер драчовый или квант говёный ставить.
Данный же движок решили написать конкретно под Qwen3.8-Flash-Next чтобы использовать его фишки по максимуму, а не иметь костыль для всех ЛЛМ.
План сработал, даже он был перевыполнен, Квен 3.8 Флеш Некст полетел быстрее примерно в четыре пять раз.
Да, там написано "раз". Это не шутка и не анекдот.
Но это по началу, когда пилили только под Блэквэл 5000 серию видюх, потом вошли во вкус и начали пилить вообще под всё что пилится. Заработало и на 2000-3000-4000 серии Нвидей, чё-то там на Радионах заработало. Отмечены случаи запуска на древних Амперах типа 1070-1080 картах и Теслах V100. Ну не быстро, токенов в 15-20, но по сравнению с 1-2 токенами ранее, это космос.
Такие вот делишки!
По себе могу сказать, допустим в ЛМ Студии в начале года Квен 3.6 большой работал у меня примерно в 5 токенов в секунду. Осенью, когда только вышел Qwen3.8-Flash-Next , он у меня тоже заработал в ЛМ Студии в +-5 токенов, но народ уже начал оптимизировать и делать форки Лламы и уже в Унслот Студии, было целых 19-20 токенов в секунду на двух видеокартах 5060ti по 16 и около 25т/с на двух 3090! Ну, а тут стало быть, на Страте, на одной карте 5060ti 16 гб, поперло в 50+ токенов на 4 кванте NVFP4, а на IQ3-xxs полетело под 70-80 токенов.
В общем очень быстро работает, очень, есть пробитие. Чем лучше ящик, тем быстрей, на ДДР5 с AVX512 инструкциями оно чё-то там за 100 токенов уже улетает у народа.
Рекомендую! Пробуйте!
Ставится легко, идём по инструкции через ГИТ закачиваем к себе или просто скачиваем ZIP архивом репозиторий и запускаем "START-HERE.bat".
Отвечаем на вопросики из которых важные про модель, в зависимости от форка Страты, если вы до этого добрались, будут разные модели. Из того чем я пользуюсь "swift-1.5-iq3_xxs", можно подумать квант такой говно, но сейчас они уже не говно, неплохой квант, самый быстрый из вменяемых, но есть и получше "unsloth-UD-IQ4_XS" или Q4_K_XL, но и помедленней.
Форки! Да есть ещё и форки, вот изолента форк:
Strata-nvfp4
Strata fork: Qwen3.8-Flash-Next 125B MoE in NVFP4 on one RTX 20-50 card (12 GB+) and 64 GB of RAM or more.
Тут движок переделанный под нативный формат NVFP4 Блэквелам или 5000 серии Нвидей.
В этом форке при установке можно выбрать ещё моделей, например "qwen3.8-flash-next-gptq-nvfp4" очень хорошая модель с точностью получше просто Q4. Тоже поглядел, понравилась больше всего.
Что ещё там есть? Vision, если его не включить то моделька не сможет читать картинки если вы их кидаете в чатик.
Унцензурность, можно включить унцензурность любой модели, в форке Strata-nvfp4 при первичной настройке, но на самом деле в обычной Strate тоже можно её врубить, надо будет в НашаМодель.json добавить нужные параметры.
Например параметры для конфига ВыбраннаяМодель.json для не форкнутой Страты:
Ещё при настройке из сетапа нельзя будет добавить словарик чтобы быстрее кирилица обрабатывалась и жрала меньше токенов, но можно добавить ключем или просто вписать в конфиг
PHP код:
  "--mtp-draft-vocab",

  "draft_vocab_cyrillic.bin",
Всё, вроде больше ничего интересного, остальное так можно добавить.
Например, чтобы наша модель была доступная по сети с ящика где запущена нужно добавить в .BAT файл который родится после первичной настройки такое
Само собой можно модель зацеплять по API за наши ОпенКоды или другие штуки который используют ОпенИИ, Антропик совместимое АПИ.
PHP код:
Any OpenAI- or Anthropic-compatible client works with these addresses.

OpenAI base URL: http://127.0.0.1:8080/v1

Anthropic base URL: http://127.0.0.1:8080

Model name: qwen3.8-flash-next-gptq-nvfp4 или какая там у нас модель по имени из конфига
Ну и всё, врываемся, можно творить всякое используя Унцензурность, Аблитиративность и прочую агрессивность, за токены платить не надо, у вас неплохая, а по меркам 2024-2025 годов, вообще, пушка бомба модель.
Пользуйтесь на здоровье!
Последний раз редактировалось DungeonKeeper; 11.10.2026 в 17:18.
Причина: очепятки, добавил
lolz i dont remember i ever said pidaras in normal chat
Полезная информация . У меня 5070 ti, 64 гб оперативной памяти .
Использую на постоянной основе данную модель -
huggingface.co/hesamation/Qwen3.6-35B-A3B-Claude-4.6-Opus-Reasoning-Distilled-GGUF
Это обученная модель квин 3.6 на данных клауд 4.6.
Квантование использовал разное от 4 до 6, комп все тянет . Но читал что больше 4 использовать бесполезно , мощность плюс минус одинаковая , а скорость падает в разы .
Попробую твой вариант, отпишусь
И вопрос, может кто шарит - я хочу обучить модель на своих данных, материалах . Как это можно реализовать ?
И вопрос, может кто шарит - я хочу обучить модель на своих данных, материалах . Как это можно реализовать ?
Квест вроде и простой и сложный одновременно. Инференс проще обучения которое требует в разы больше ресурсов. А данные нужно скармливать не просто так, а предварительно размечать, т.е. делать "датасет", что отдельная наука у нейронщиков.
Пока выход для народа из простого. Недавно начали пилить опенсорсный ответ LM Studio называется он Unsloth Studio.
В целом штука сыровата, версии 0.хх, но неплоха и стремительно развивается с начала этого года. Для запуска моделей использует уже всякие форки Лламы.цпп что сказывается по скорости, в отличии от ЛМ Студии модели в неленивом Унслотхе работают уже быстрей.
Вот в ней, по мимо всяких картиночных и прочих для создания видео приколов, добавили и обучение на своих данных. Само собой делает она не модели, а так называемые Лоры к моделям, потому что модель сделать, это надо Алибабой каким-нибудь стать.
В общем погляди, вроде как народ по мелочи чего-то за вменяемое время делает, говорят неплохо и удобно в отличии от консольных вариантов.
lolz i dont remember i ever said pidaras in normal chat
Это то, с чем мы тyт мyчаемся? Отключение проверок на законность?
Что это? Зачем?
Это всё одно и то же, по науке отключение отказов у моделей, или отключение внутренней цензуры, чтобы они отвечали в 99% или в 100% случаев на любой вопрос.
Делается это всё чаще всего скриптом Еретик.
Но кто поумней потом ещё дотюнивают чтобы было совсем хорошо, потому что просто Еретик может чё-то поломать в логике по мимо битвы с цензурой.
На Хагфейсе нужно смотреть модели с припиской Uncensored, Abliterated.
Есть ещё собственно приписка Heretic, значит то же самое, народ прост приписывает как есть не заморачиваясь.
Aggressive значит модель будет ещё и более прямолинейная и выдавать сразу как есть всё что знает.
Ну как я это понял, конечно, я тестил и Агрессивные и средние модели, на своих делишках разницы не заметил, но у они у меня такие, я всё же не ломаю ничего, но инженера есть которые девопсят тут у меня, говорят норм, тоже разницы не заметили.
По идее для реверса это и не пригодится, главное чтобы были отключены отказы.
В Страте это делается через конфиг после того как уже модель установлена докидываеним строек запускающих мини модель которая это делает.
В Strata-NVFP она спрашивает при установке.
В обоих случаях действует на любую подключенную модель Квен 3.8 Флеш Некст.
Если не Страта а ЛМ или Унслот студия, то надо выбирать модельки от проверенных Унцензурщиков, я например беру Оркароутера и ХауХауЦС, ещё популярный ХуиХуи-Аи. Говорят очень качественные унцензурные модели делает.
Цитата:
Пацаны, и где нынче модно видяхи покyпать? Чёто появилось желание докyпить оперативы и 4060/5060 на 16 gb. И есть ли смысл смотреть в сторонy авито?
Даааа. В непростое время ты поднял этот, невероятно насущный вопорос.
По мимо всего прочего, данный движ резко увеличил число желающих собирать домашние ИИ серверы, а различные Инферы, Страты и прочие форки подняли ценность обычных видюх от 12 гигабайт видеопамяти и всё это стремительно сейчас дорожает.
Брать где ещё продают, но 5090 я бы брать не стал, она уже по 700 штук в ДНС, за те же бабки сейчас пока ещё можно набрать 5060ti видюх, они пока по +-80к.
Оператива пздц сколько стоит, это больно. Но если городить на ДДР4 то не так как на ДДР5.
Ценник везде конский, и на Авите у сетевиков, потому что оверхайп.
Вообще сборка сервера сейчас выглядит так:
Закупается материна серверная или переделка из серверной в Е-АТХ, на АМД Эпиках или Зионах, можно на Тредриперах, средней свежести, чтобы был 6-8 канальный контроллер памяти и слоты на мамке PCIe 16х более одного.
Оператива ДДР4 или ДДР5, у кого сколько денег, от 64 гигов.
Но я бы не стал так заморачиваться, если это прямо срочно не надо зарабатывать миллионы. В целом видюхи работают и через 4х 8х PCI Экспресс в обычных мамках. С Стратой тут стало проще.
Можно купить две карты Nvidia типа 5060ti - 16 гигабайт или 2080ti с 22 гигами, или 3090 и воткнуть в обычный комп.
5060ti или 5070ti будут новые, пока ещё стоят не адски дорого, самые свежие, поддерживают NVFP4, и их можно взять без геморроя.
Как я писал в теме уже сейчас на одной карте с 16 гигами, Страта выдаёт неплохой инференс в 50+ токенов.
Но для плотных моделей типа Квина 3.8 27Б, да, надо будет уже 32 гига видеопамяти набрать двумя картами.
Последний раз редактировалось DungeonKeeper; 11.10.2026 в 18:49.
lolz i dont remember i ever said pidaras in normal chat
Это всё одно и то же, по науке отключение отказов у моделей, или отключение внутренней цензуры, чтобы они отвечали в 99% или в 100% случаев на любой вопрос. Оффтоп
Делается это всё чаще всего скриптом Еретик.
Но кто поумней потом ещё дотюнивают чтобы было совсем хорошо, потому что просто Еретик может чё-то поломать в логике по мимо битвы с цензурой.
На Хагфейсе нужно смотреть модели с припиской Uncensored, Abliterated.
Есть ещё собственно приписка Heretic, значит то же самое, народ прост приписывает как есть не заморачиваясь.
Aggressive значит модель будет ещё и более прямолинейная и выдавать сразу как есть всё что знает.
Ну как я это понял, конечно, я тестил и Агрессивные и средние модели, на своих делишках разницы не заметил, но у они у меня такие, я всё же не ломаю ничего, но инженера есть которые девопсят тут у меня, говорят норм, тоже разницы не заметили.
По идее для реверса это и не пригодится, главное чтобы были отключены отказы.
В Страте это делается через конфиг после того как уже модель установлена докидываеним строек запускающих мини модель которая это делает.
В Strata-NVFP она спрашивает при установке.
В обоих случаях действует на любую подключенную модель Квен 3.8 Флеш Некст.
Если не Страта а ЛМ или Унслот студия, то надо выбирать модельки от проверенных Унцензурщиков, я например беру Оркароутера и ХауХауЦС, ещё популярный ХуиХуи-Аи. Говорят очень качественные унцензурные модели делает.
Даааа. В непростое время ты поднял этот, невероятно насущный вопорос.
По мимо всего прочего, данный движ резко увеличил число желающих собирать домашние ИИ серверы, а различные Инферы, Страты и прочие форки подняли ценность обычных видюх от 12 гигабайт видеопамяти и всё это стремительно сейчас дорожает.
Брать где ещё продают, но 5090 я бы брать не стал, она уже по 700 штук в ДНС, за те же бабки сейчас пока ещё можно набрать 5060ti видюх, они пока по +-80к.
Оператива пздц сколько стоит, это больно. Но если городить на ДДР4 то не так как на ДДР5.
Ценник везде конский, и на Авите у сетевиков, потому что оверхайп.
Вообще сборка сервера сейчас выглядит так:
Закупается материна серверная или переделка из серверной в Е-АТХ, на АМД Эпиках или Зионах, можно на Тредриперах, средней свежести, чтобы был 6-8 канальный контроллер памяти и слоты на мамке PCIe 16х более одного.
Оператива ДДР4 или ДДР5, у кого сколько денег, от 64 гигов.
Но я бы не стал так заморачиваться, если это прямо срочно не надо зарабатывать миллионы. В целом видюхи работают и через 4х 8х PCI Экспресс в обычных мамках. С Стратой тут стало проще.
Можно купить две карты Nvidia типа 5060ti - 16 гигабайт или 2080ti с 22 гигами, или 3090 и воткнуть в обычный комп.
5060ti или 5070ti будут новые, пока ещё стоят не адски дорого, самые свежие, поддерживают NVFP4, и их можно взять без геморроя.
Как я писал в теме уже сейчас на одной карте с 16 гигами, Страта выдаёт неплохой инференс в 50+ токенов.
Но для плотных моделей типа Квина 3.8 27Б, да, надо будет уже 32 гига видеопамяти набрать двумя картами.
Возьми да установи GPT-OSS-20b он в режиме чата 100+ т/с выдаст на DDR5 и 5060ti с 16гб. Qwen2.5 или Qwen3 семейства Coder тоже самое. А весит всё это безобразие всего 14гб с кэшем в 8bit. Скорость такая что не успеваешь читать. Да только он бестолковый как пробка и много ошибается. Просишь что-то сделать и если не следить за каждым шагом он отчитывается что 100% GTA6 написал за 1 минуту. При том что даже папку не смог создать. Qwen3.8 тоже удивляет если не бдить. Так же может выдавать перлы.
Скорость не равно качество.
P.S.Я кстати не понимаю, зачем все сидят на LLama и прочем ?
LM Studio делает тоже самое, только половину настроек и оптимизаций делает в режиме auto. А другую половину можно настроить обычным ползунком. А недавно завезли фишку от "Бабы Ванги". Можно распределить количество слоёв модели и контекста с кэшем и сама студия покажет ожидаемое количество занимаемых ресурсов. Вплоть до OfM
P.P.S. у 20 и 30 серии старая архитектура и половина новомодных квантований и прочих наворотов может не работать. Нужно прям внимательно изучать темы и модели.
Последний раз редактировалось BigBan; 14.10.2026 в 09:37.
Возьми да установи GPT-OSS-20b он в режиме чата 100+ т/с выдаст на DDR5 и 5060ti с 16гб. Qwen2.5 или Qwen3 семейства Coder тоже самое. А весит всё это безобразие всего 14гб с кэшем в 8bit. Скорость такая что не успеваешь читать.
Какие Гопотаоси и Квины 2,5, сейчас 2026-той года, а не 2024-тый.
С ИИ, в том числе и локальным, есть ещё один интересный момент, всё очень быстро меняется. Причем ещё и ускоряется.
Чтобы не выпасть сразу в эпоху динозавров, желательно следить за этими трендами.
Цитата:
Qwen3.8 тоже удивляет если не бдить. Так же может выдавать перлы.
Положняк такой, всё что выходило до Квина 3.8, можно смело удалять.
Особенно всякие ГопотаОСЫ, Немотроны и Геммы.
Цитата:
Скорость не равно качество.
А качество не ровно скорость.
Оно там тоже сильно различается по времени от поколения моделей.
Допустим современная сильно квантованная модель за счет лучшей проработки, оптимизаций и архитектуры, будет лучше старой даже не квантованной.
Цитата:
LM Studio делает тоже самое,
ЛМ Студия использует ту же Лламу.цпп если что.
Причем самую дефолтную, по этому сейчас ЛМ Студия это самое днище из подобных штук.
Однако ЛМ Студию ещё не использует и сама ЛМ Студи, они там Бионик теперь активно пилят, потому что Агенты рулят.
Хотя, с появлением Дипсик Харнеса, да и по сравнению с Гермесом, Бионик по моему тоже лажа.
Цитата:
Можно распределить количество слоёв модели и контекста с кэшем и сама студия покажет ожидаемое количество занимаемых ресурсов. Вплоть до OfM
Это довольно давно в ней появилось, по меркам ИИ, можно сказать, что это появилось примерно во времена Римской Империи. :)
Цитата:
P.P.S. у 20 и 30 серии старая архитектура и половина новомодных квантований и прочих наворотов может не работать. Нужно прям внимательно изучать темы и модели.
В Страте, да и в других форках Лламы, эти все моменты учтены сообществом. Можно сказать работает уже на всём.
Там если что 1.44+ версия уже вышла, всё ещё быстрей заработало.
Если что, у меня на одной карте 5060ti с 16 гигами, unsloth/Qwen3.8-Flash-Next UD-Q4_K_XL, около 50-60 токенов выжимает.
lolz i dont remember i ever said pidaras in normal chat
В версии 1.44+ добавили поддержку Qwen3.6-35B-A3B, для любителей ИИ старены глубокой, целой полугодовой давности. Зато сразу вплоть до Q8_0.
Наверное это хорошо, но как по мне Квин 3.8 всё ровно лучше.
Ещё какие-то переквантовки от Унслота для Квина 3.8 тоже теперь с большими квантами добавили. Но работать они будут не так бодро как UD-Q4_K_XL
И добавили форк NVFP4 в основную Страту, теперь всё вместе работает.
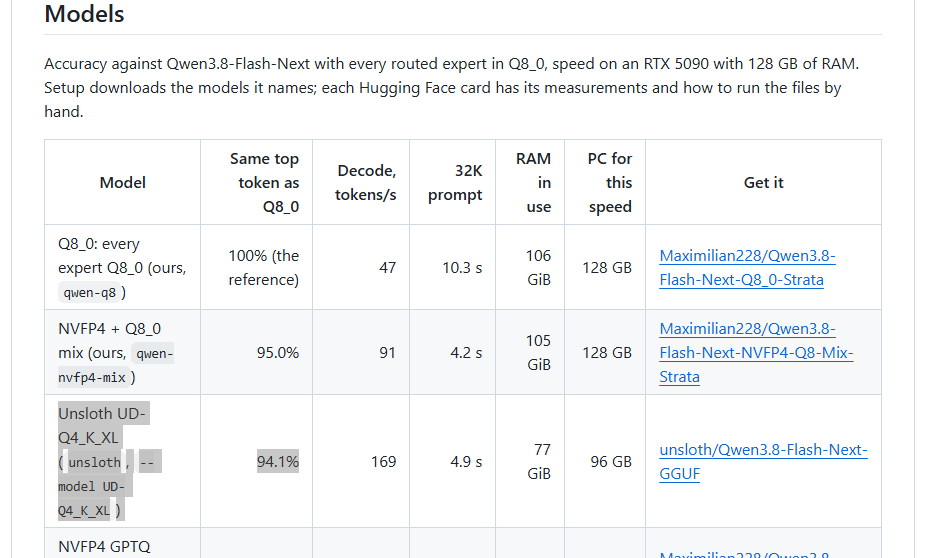
Unsloth's UD-Q4_K_XL, UD-Q5_K_XL, UD-Q6_K_XL and Q8_0 are regular choices in setup, next to UD-IQ4_XS (docs/QUANTS.md). UD-Q4_K_XL is no longer experimental or NVIDIA-only; the three larger files and Q8_0 are new, each pinned by size and SHA-256. Where the experts fit in RAM with 16 GiB to spare, setup keeps every expert in RAM (UD-Q4 on a 64 GB PC with the old budget rule against this rule, 5 interleaved pairs: decode x1.34-1.40, a 4K prompt x2.07). Images are on by default for these files.
Quality against Q8_0 (4,995 teacher-forced positions): UD-Q6_K_XL 94.6% same top token (mean KL 0.033), UD-Q5_K_XL 94.6% (0.038), UD-Q4_K_XL 93.1% (0.056), UD-IQ4_XS 88.9% (0.101), IQ3_S 87.7% (0.144), IQ3_XXS 84.5% (0.202), Q2_0 80.6% (0.315). tools/quant_quality.py reruns it on your own files.
Speed (one R9700, every expert in RAM): UD-Q4_K_XL 63 tok/s on a story and 85-88 on code; UD-Q5_K_XL 57-60 and 81-83; UD-Q6_K_XL 54 and 76; Q8_0 53-57 and 66-74. llama.cpp on the same box: 16-20 tok/s decode.
The K-quant prompt kernels are built by default; on NVIDIA they are a library of their own (strata_kq, shipped in the Windows zips), opened only when a model has these formats, so no other model pays for them. They are opt-in at run time (STRATA_MMQ_KQ=1): prompts x1.3-1.7 on AMD with every expert in RAM, with a prompt-path KL change we have not yet judged on enough text to make it the default.
Dense Q8_0 matrices read one row per block where that measured faster (RDNA4 and sm_86), the same bits as before: decode +2.8 to +3.8% on UD-Q4 (5/5 pairs).
NVFP4 packs (docs/NVFP4.md; sergiywith's port of sergqwer's strata-nvfp4 work). The original model with NVFP4 experts, as ready-made packs (GPTQ by default, NVIDIA's own checkpoint second), pinned and SHA-256-checked, with the original's image encoder. RTX 50 cards have FP4 tensor cores; older RTX cards run the experts at 8-bit precision and UD-IQ4_XS is faster there, which is what setup's menu now says. Quality against Q8_0: 92.1% same top token (KL 0.070), between UD-IQ4_XS (88.9%) and UD-Q4_K_XL (93.1%). NVIDIA only; AMD and Intel setups do not list it. The route tail skip stays off for NVFP4 experts (it costs more quality there); STRATA_ROUTE_TAIL_SKIP=7 turns it on.
Qwen3.6-35B-A3B (UD-Q4_K_XL, UD-Q6_K_XL, Q8_0), with the file's own MTP block for speculative decode. One strata binary now runs both families (the file's architecture decides). Setup offers it as the last family in the model menu and sizes it by RAM (32 / 44 / 52 GB). On an R9700 UD-Q4_K_XL: 3,466 tok/s on a 4K prompt and 83 tok/s decode (llama.cpp on the same card: 3,054 and 82), about 161 tok/s with --mtp 2; exact against the plain decode on our 10 parity prompts. On an RTX 3060 with 46 GB of RAM (hybrid mode, experts in RAM): 4K prompt 1.47x llama.cpp's best split. NVIDIA and AMD only; the Intel (SYCL) engine and the Mac engine refuse it with a clear message.
Image generation is in preview (POST /v1/images/generations, off unless a config asks for it): setup does not offer it yet.
A 780M iGPU joins the gfx11 WMMA kernels (decode x1.53 on a Radeon 780M, same answers), and the Vulkan image decoder works in tiles (a 1024x1024 image's VAE: 23 s instead of 45 s).
lolz i dont remember i ever said pidaras in normal chat
В версии 1.44+ добавили поддержку Qwen3.6-35B-A3B, для любителей ИИ старены глубокой, целой полугодовой давности. Зато сразу вплоть до Q8_0.
Наверное это хорошо, но как по мне Квин 3.8 всё ровно лучше.
Ещё какие-то переквантовки от Унслота для Квина 3.8 тоже теперь с большими квантами добавили. Но работать они будут не так бодро как UD-Q4_K_XL
И добавили форк NVFP4 в основную Страту, теперь всё вместе работает.
Unsloth's UD-Q4_K_XL, UD-Q5_K_XL, UD-Q6_K_XL and Q8_0 are regular choices in setup, next to UD-IQ4_XS (docs/QUANTS.md). UD-Q4_K_XL is no longer experimental or NVIDIA-only; the three larger files and Q8_0 are new, each pinned by size and SHA-256. Where the experts fit in RAM with 16 GiB to spare, setup keeps every expert in RAM (UD-Q4 on a 64 GB PC with the old budget rule against this rule, 5 interleaved pairs: decode x1.34-1.40, a 4K prompt x2.07). Images are on by default for these files.
Quality against Q8_0 (4,995 teacher-forced positions): UD-Q6_K_XL 94.6% same top token (mean KL 0.033), UD-Q5_K_XL 94.6% (0.038), UD-Q4_K_XL 93.1% (0.056), UD-IQ4_XS 88.9% (0.101), IQ3_S 87.7% (0.144), IQ3_XXS 84.5% (0.202), Q2_0 80.6% (0.315). tools/quant_quality.py reruns it on your own files.
Speed (one R9700, every expert in RAM): UD-Q4_K_XL 63 tok/s on a story and 85-88 on code; UD-Q5_K_XL 57-60 and 81-83; UD-Q6_K_XL 54 and 76; Q8_0 53-57 and 66-74. llama.cpp on the same box: 16-20 tok/s decode.
The K-quant prompt kernels are built by default; on NVIDIA they are a library of their own (strata_kq, shipped in the Windows zips), opened only when a model has these formats, so no other model pays for them. They are opt-in at run time (STRATA_MMQ_KQ=1): prompts x1.3-1.7 on AMD with every expert in RAM, with a prompt-path KL change we have not yet judged on enough text to make it the default.
Dense Q8_0 matrices read one row per block where that measured faster (RDNA4 and sm_86), the same bits as before: decode +2.8 to +3.8% on UD-Q4 (5/5 pairs).
NVFP4 packs (docs/NVFP4.md; sergiywith's port of sergqwer's strata-nvfp4 work). The original model with NVFP4 experts, as ready-made packs (GPTQ by default, NVIDIA's own checkpoint second), pinned and SHA-256-checked, with the original's image encoder. RTX 50 cards have FP4 tensor cores; older RTX cards run the experts at 8-bit precision and UD-IQ4_XS is faster there, which is what setup's menu now says. Quality against Q8_0: 92.1% same top token (KL 0.070), between UD-IQ4_XS (88.9%) and UD-Q4_K_XL (93.1%). NVIDIA only; AMD and Intel setups do not list it. The route tail skip stays off for NVFP4 experts (it costs more quality there); STRATA_ROUTE_TAIL_SKIP=7 turns it on.
Qwen3.6-35B-A3B (UD-Q4_K_XL, UD-Q6_K_XL, Q8_0), with the file's own MTP block for speculative decode. One strata binary now runs both families (the file's architecture decides). Setup offers it as the last family in the model menu and sizes it by RAM (32 / 44 / 52 GB). On an R9700 UD-Q4_K_XL: 3,466 tok/s on a 4K prompt and 83 tok/s decode (llama.cpp on the same card: 3,054 and 82), about 161 tok/s with --mtp 2; exact against the plain decode on our 10 parity prompts. On an RTX 3060 with 46 GB of RAM (hybrid mode, experts in RAM): 4K prompt 1.47x llama.cpp's best split. NVIDIA and AMD only; the Intel (SYCL) engine and the Mac engine refuse it with a clear message.
Image generation is in preview (POST /v1/images/generations, off unless a config asks for it): setup does not offer it yet.
A 780M iGPU joins the gfx11 WMMA kernels (decode x1.53 on a Radeon 780M, same answers), and the Vulkan image decoder works in tiles (a 1024x1024 image's VAE: 23 s instead of 45 s).
Скачал этот проект, запустил у себя Qwen3.8 Coder.
Работает ~50 т/с (у меня скромненько 32+22 RAM+VRAM). Распределение весов удивило. "Умная оптимизация" творит чудеса. На сколько я понял, там распределяются "мёртвые специалисты" в ОЗУ. А всё что пригодно для работы - в VRAM.
Из минусов:
Язык: Модель начинает писать на русском языке и закnishes in English language. Это тупо, весело и занятно.
Память: "Как не крутись а жопа сзади". Волшебства не случилось. Под Qwen Next на 256гб весом, всё ещё нужно 256гб какой-нибудь памяти. А хочется локальный KIMI K3 на 3Т параметров запускать локально на ноутбуке из 2011.
P.S. Сейчас на хайпе ПК за 30к с 2 зеонами на 64 потока (32+32) и 64ГБ+ серверной ECC REG памяти. 5-15 т/с на Qwen Next (Flash) важнее чем 50 т/с на Qwen3.6-35B-A3B
P.P.S. Кто нибудь, собирал уже кластер из локальных ИИ ? А то мысль есть, а способа проверить нету.
Последний раз редактировалось BigBan; 19.10.2026 в 04:10.








 Говорят очень качественные унцензурные модели делает.